AI随心创
先说结论
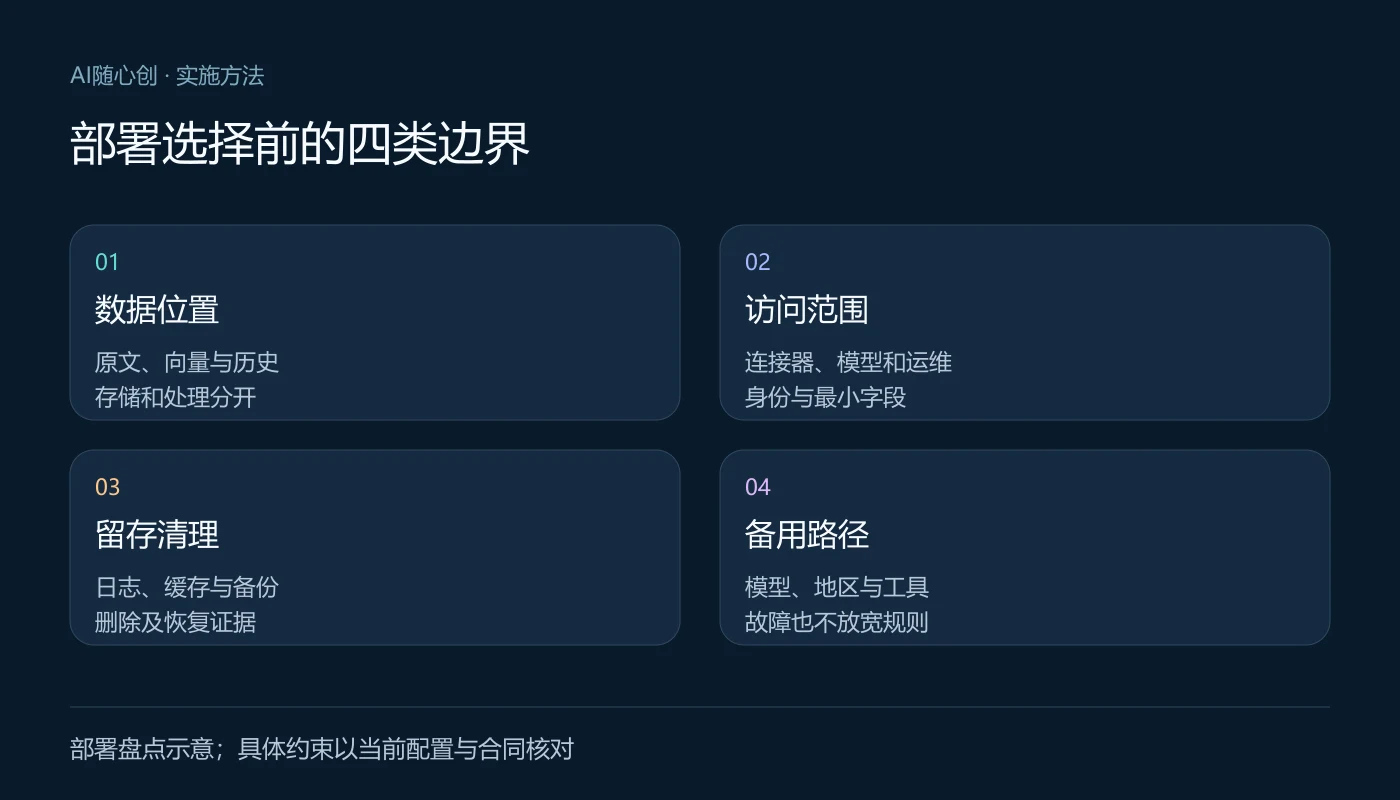
企业 AI 部署选型应逐段核对原文、检索片段、模型输入输出、日志和备份的存储位置、处理位置与留存。知识库放在内网不代表模型调用也在内网;私有部署也需要更新、备份与运行人员权限。先确认数据约束,再比较成本、容量和维护条件。
读完你会得到
- 存储位置和处理位置分别记录。
- 状态历史、遥测与备份也纳入部署范围。
- 备用模型与跨区切换遵守同一数据约束。
“资料留在本地”常被当成一句足够的承诺。但系统可能把检索到的合同段落发给外部模型,把完整输出保存到遥测平台,故障时又切到另一地区。选型会议需要一张能逐项核对的数据流表。
配套资料与延伸阅读
- 知识库资料更新后还在答旧规则:怎样管理版本、撤回和缓存(阅读)
继续阅读相关方法与边界。
- 上下文工程如何落到企业任务:状态、资料引用与压缩分别管理(阅读)
继续阅读相关方法与边界。
- 企业 AI / FDE 服务(了解)
带上数据分类、现有系统和允许出站范围,可用于讨论企业 AI 部署与集成的试点边界。
先列数据对象,再比较部署名称
| 对象 | 经过的环节 | 需要取得的证据 |
|---|---|---|
| 原始文件与业务记录 | 上传、解析、同步 | 连接器权限与复制位置 |
| 切片与向量 | 嵌入、索引、重建 | 嵌入调用去向与删除传播 |
| 提问与检索片段 | 编排、模型推理 | 调用端点、处理区域与身份 |
| 输出与会话历史 | 客户端、状态存储 | 保留期与撤销访问方式 |
| 日志、缓存与备份 | 遥测、运维、恢复 | 脱敏字段、访问者与清理规则 |
用一件真实任务把每个对象走一遍,记录谁发送、谁存储、谁能访问和何时清除。图中暂时无法确认的节点应标待核实,不能用“企业级”三个字替代证据。
分开看三种可实施模式
云托管适合希望复用模型运维与容量的平台条件,但要核对产品、功能和部署类型的数据处理说明。混合部署把业务系统或检索留在受控环境,同时调用外部推理;需要明确哪些内容允许出站。自托管把推理与主要组件放在自己的环境,但硬件、更新、安全补丁、备份与值班责任会增加。
这些模式没有统一优胜者。关键业务要求与团队维护能力不一致时,应调整任务范围或数据处理方式。采购前让同一业务题在候选方案中运行,记录质量、延迟、故障处理和长期维护成本,不用产品演示代替生产验收。
不要把“不训练”理解成“不处理或不留存”
微软当前的 Azure 模型数据说明分别讨论输入输出、上传数据和有状态功能的存储。这说明“是否用于基础模型训练”“提供服务如何处理”“可选历史如何保留”是不同问题。其声明适用指定的 Azure 产品和功能,不能推及所有供应商、模型市场或个人账户。
逐项取得当前产品说明、合同约定与实际配置。存储区域、处理区域、人员访问和删除时间可能有不同边界,尤其要核对全局部署、跨区路由和可选状态功能。文章提供技术盘点方法,具体合同与适用法规应由企业负责人员核实。
本节依据: [3] Microsoft Learn
对一份售后文件进行出站演练
教学数据流检查
- 放入虚构文件
使用假订单和联系人,保留格式但不含真实个人资料。
产出:演练文件与数据分类 - 记录每次出站
分别记录解析、嵌入、重排和生成调用的目标与字段。
产出:端点及最小数据表 - 检查状态副本
查询会话、缓存、异常日志、追踪与备份是否包含片段。
产出:副本和负责人清单 - 执行清理与恢复
删除演练资料,再检查索引、缓存和恢复后的访问状态。
产出:清理证据与恢复限制
抓取网络目标时不输出凭证。需要进一步确认服务器端处理位置时,应以供应商当前说明和合同为依据,网络目标域名或 IP 本身无法证明全部后台处理都在某个地区。
例如企业约定只允许发送匿名产品问题,那么演练中应故意放入假联系人、订单号和合同片段。验证请求在进入外部端点前被脱敏或拒绝,并检查异常日志是否仍保存了原字段。正常路径通过后,再模拟备用模型、批处理上传和会话恢复,核对每条路径都遵守同一规则。
脱敏应有可以检查的输入输出样本,不能只在界面提示“已处理”。如果无法确认某条路径实际发送了哪些字段,就暂停该路径并记录未知项;不能把暂时没有观察到泄露解释为完整数据边界已经通过。
降级路径不能放宽数据规则
主要端点超时后,系统可能自动选择另一个模型、地区或工具。每条候选路径应同时检查模型能力、授权、数据分类和处理约束。没有允许的备用路径时,进入等待或人工处理,不为保持“总能回复”而绕过规则。
失败任务的提示、工具结果与日志也不能无限保留。重试和恢复需要稳定意图标识,防止已经执行的业务动作再次发生。数据出站失败、生成失败和业务执行失败分开记录;它们需要不同的补救方法。
自托管要算上可持续运行责任
除推理机器,还要考虑驱动与依赖、模型文件来源、版本更新、容量余量、备份恢复、监控脱敏和访问管理。自托管并不让这些责任消失。交付前安排恢复演练,确认另一位维护人员能按记录接管,而不只由最初搭建者操作。
如果流量明显有峰谷,比较闲置成本与峰值排队。云服务有配额与实际容量的区别,自托管有显存与任务耗时的限制。验收报告应写明测试负载、允许等待时间和超过范围后的行为,不能把一次低并发演示当作容量承诺。
本节依据: [2] Microsoft Learn
把部署决策写成可复查的约束
最终记录允许的数据分类、各节点的存储与处理位置、调用身份、留存与清理、备用路径、备份恢复,以及企业和供应商各自负责的事项。未知项需要决定人和核实时间。
试点先处理可脱敏任务,保留完整数据流和评测记录。新增上传格式、连接器、有状态功能或备用模型时重新核对,不沿用最初选型的一句承诺。部署方案只有和实际任务、配置及运行证据对应,才方便后续验收和维护。
常见问题
知识库在本地,合同片段就不会发到外部吗?
不一定。嵌入、重排或生成可能调用外部服务。需要逐次核对发送字段与处理端点,不能只看向量库的位置。
私有化部署可以免做数据治理吗?
不能。权限、副本、日志、备份、清理和维护人员访问仍需管理;自托管只改变责任和环境,不替代这些措施。
资料来源与核对说明
文章中的行业定义与技术方法尽量引用官方或标准组织资料;表格、清单和决策框架是基于这些资料形成的编辑性整理,不代表来源机构对本站服务的背书。
- Data platform for AI workloads on AzureMicrosoft Learn
核验于2026-10-09。官方建议先判断现有数据平台能力,新增组件需有用途,考虑版本与生命周期。本站数据流盘点和业务表格为实施建议。
- Provisioned throughput for Foundry ModelsMicrosoft Learn
核验于2026-10-09。官方区分配额与实际容量、标准与预置吞吐;具体模型和部署条件以当前文档为准。文中任务量与排队数为教学演算,不是PTU性能承诺。
- Data, privacy, and security for Models sold by Azure in Microsoft FoundryMicrosoft Learn
核验于2026-10-09。原链接重定向至当前Foundry隐私说明,分别说明提示、上传数据和状态存储;仅适用该页指定产品与配置,不推广为所有云服务的保证。
带上流程、样例和目标,添加企业微信沟通。先确定项目范围与验收方式,再安排实施。