AI随心创
先说结论
AI 测试集应记录输入、可用证据、允许动作、应达到的业务结果和评分依据。专家意见不同,先检查规则、资料和时间范围;不能确认唯一答案时标记为待澄清或允许多个合格结果,不用多数票掩盖业务规则空缺。
读完你会得到
- 标准答案可以是可接受的结果范围,不必是一段固定文案。
- 评分前检查输入证据是否足够、业务规则是否明确。
- 开发样本和保留测试分开,线上失败持续补入。
两位售后主管面对同一申请,一位说应该退款,另一位说先补照片。若把其中一个答案直接写进“标准答案”,模型可能被训练成执行一条从未正式确认的规则。本文用这类分歧说明如何做可维护的测试集。
配套资料与延伸阅读
- FDE 项目怎么验收:一张 AI Agent 测试与放行表(阅读)
相关方法与实施说明
- 15|Agent 表现不错,凭什么决定进入试点?(阅读)
相关方法与实施说明
- 企业 AI / FDE 服务(了解)
准备脱敏任务与现行规则,便于讨论企业 AI 评测集、验收条件和维护方式。
先写任务结果,再写回答长什么样
测试集的每行是一项任务,不是只放一个问题和一段答案。记录当时可见资料、用户权限、期望结果和禁止动作。对于工单分流,正确结果可能是队列和缺失字段;对于资料问答,正确结果可能是引用适用条款并说明限制。
Anthropic 的 Agent 评测文章区分一次尝试、执行轨迹和环境中的最终结果,并说明代码、模型和人工评分的不同用途。本文的标注方法基于这一划分,业务例子和字段设计为本站建议。
本节依据: [1] Anthropic
一行样本至少包含这些内容
| 字段 | 示例或填写方式 |
|---|---|
| case_id | 稳定样本编号,便于追踪回归 |
| input | 用户请求与订单材料的脱敏版本 |
| evidence | 规则版本、签收时间、已有照片及访问范围 |
| expected_outcome | 转到待补材料队列,指出缺少哪个条件 |
| forbidden_action | 不得创建退款、不得编造照片或签收日 |
| acceptable_variations | 允许不同提醒措辞,但缺失条件须一致 |
| grader_and_reason | 队列用代码核对;理由由专家按规则检查 |
标注输入快照很重要。今天的规则和订单状态可能与任务发生时不同。如果评分时读取最新资料,却要求复现旧任务答案,分歧来自数据版本,不一定来自模型。
遇到分歧,按原因处理
| 原因 | 怎么确认 | 怎么处理 |
|---|---|---|
| 资料缺失 | 双方依据的字段是否相同 | 补齐证据,或期望询问补充 |
| 规则含糊 | 负责人是否认可同一解释 | 先澄清规则,样本暂不用于放行 |
| 适用范围不同 | 渠道、产品和生效日是否相同 | 写入适用条件,拆分案例 |
| 结果可等价 | 两种动作是否都满足目标与限制 | 定义多个可接受结果 |
| 标注失误 | 依据是否看错或漏读 | 更正并记录修改原因 |
不要让模型裁判替企业决定尚未确定的业务规则。模型可以帮助发现两份标注的不同点,但规则确认由有权负责的人完成。多数票适合汇总意见,不能自动成为授权依据。
可以让两位标注者先独立判断,再一起讨论;记录讨论前的一致率和主要分歧类型。一致率是检查标注说明的工具,不代表全部业务已经没有争议。
不同结果使用不同评分方法
字段格式、禁止调用的工具和最终队列适合代码检查,结果容易复现。解释是否清楚、是否漏掉重要限制可以使用带量表的模型评分,但需要与专家标注进行校准。对高影响案例和出现新规则的情况,保留人工抽查。
评分量表写具体行为。例如“答复完整”改成“列出适用期限、材料要求、例外处理渠道”。避免按文案相似度误罚正确表达,也避免因为回答流畅而放过关键业务错误。
如果任务可能产生随机输出,按同一条件重复运行并记录分布。单次通过说明一次尝试成功,不能说明每次都会成功。对少量高风险失败,应单独展示,不能被大量简单样本平均掉。
防止测试集被反复调成满分
开发集用于诊断和改进,保留测试集用于检查改动后的表现。两者都应覆盖正常、缺资料、冲突、权限和异常情况。已经拿来反复调整提示词的案例,不能再当作完全未见过的检验。
把评测版本与规则、模型、提示词、工具版本一起保存。某次结果变好,才知道改变了什么。规则更新后,检查受影响样本并写明原因,不要静默替换标准答案让历史分数不可比较。
线上失败可以补进回归集,同时去掉敏感内容并保留必要业务结构。新失败先复核输入和评分规则,避免把用户误操作或来源系统错误全部归到模型。
评分说明怎样写才不会奖励错误答案
以“缺照片的申请应提醒补充”为例,只检查回答是否包含“照片”会产生漏洞。错误回答“无需照片,已同意退款”也会匹配。代码检查应核对结构化缺失字段与最终状态;人工或模型评分还要确认说明没有反向表述和未经授权的承诺。
为评分器准备正例与反例:正确补充提醒、只给空泛建议、编造已上传材料、生成退款请求。先检查评分器能否区分这些情况,再运行大量模型样本。否则规模越大,越容易把评分错误包装成可信指标。
把争议样本与评分器修改记录一起保存。若修改后历史分数发生变化,说明新旧口径不同,报告中应重新计算同一组样本或明确断点,不把评分口径变化解释为模型能力提升。
一套小测试集如何开始
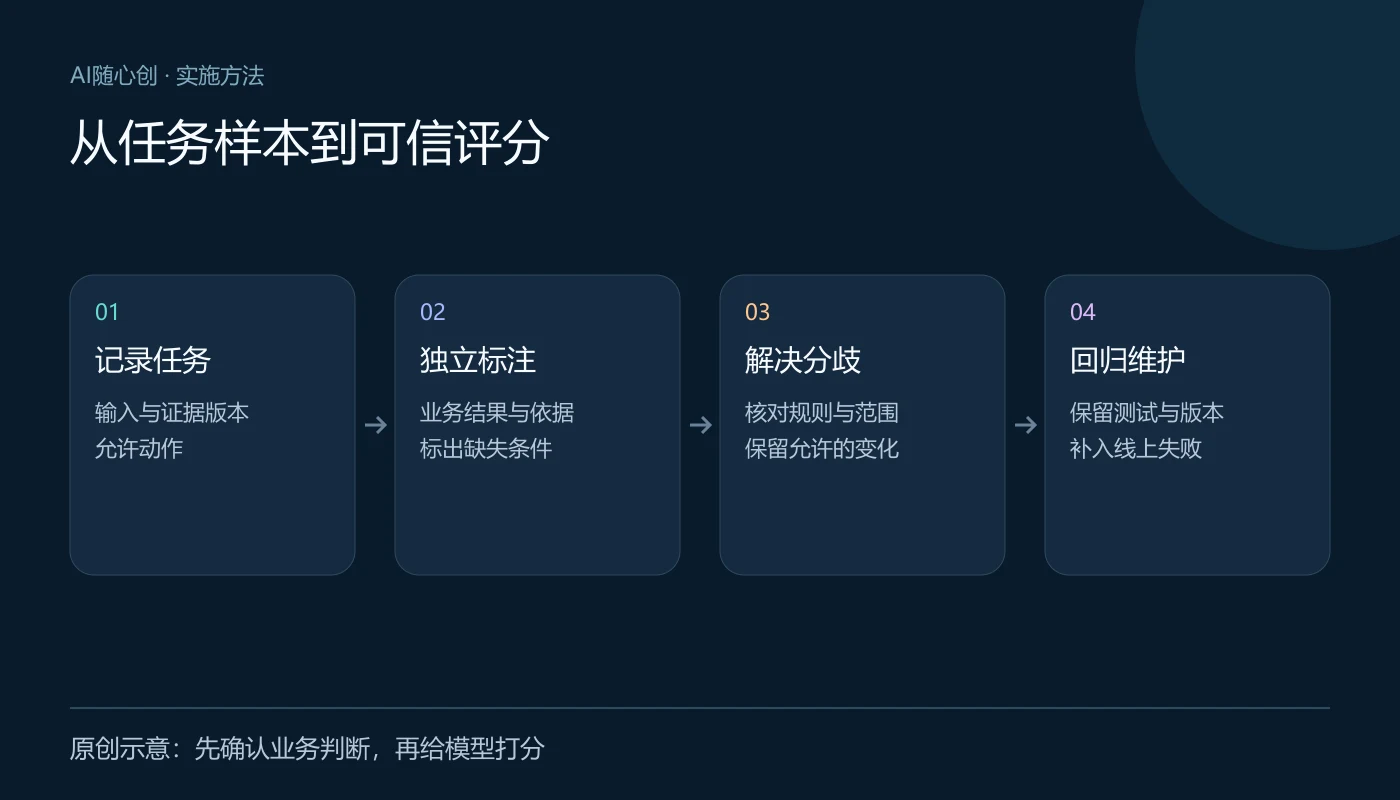
从真实任务中挑出能代表关键路径的样本,先做小规模独立标注,解决最常见分歧,再扩大数量。对规则暂未确定的样本保留“待澄清”状态,它们说明项目还缺什么,不应该被删除以获得好看的分数。
本文适合需要业务专家参与验收的分类、问答和执行型 Agent。开放创作任务可能无法设定唯一结果,需要按事实准确、格式要求和读者可用性分别评估。测试集大小、放行阈值与复跑次数应由任务风险和可获得样本决定。
常见问题
可以全部让 AI 生成测试题和标准答案吗?
可以辅助补充题型,但要由业务证据校验,避免题目和答案共同包含同一个错误。真实任务、异常案例和专家确认仍是重要来源。
专家不一致的案例都应该删除吗?
不要一律删除。先分类原因:规则待澄清的保留为阻塞事项,允许多解的定义合格范围,确有标注错误的修正。删掉难例会让评测失去代表性。
资料来源与核对说明
文章中的行业定义与技术方法尽量引用官方或标准组织资料;表格、清单和决策框架是基于这些资料形成的编辑性整理,不代表来源机构对本站服务的背书。
- Demystifying evals for AI agentsAnthropic
正文发表于 2026-01-09。用于试次、轨迹、结果及评分方法的区分。
带上流程、样例和目标,添加企业微信沟通。先确定项目范围与验收方式,再安排实施。